AI開源的下一個十年——烏鎮大講堂:把「大咖的盛會」變成「大家的盛會」
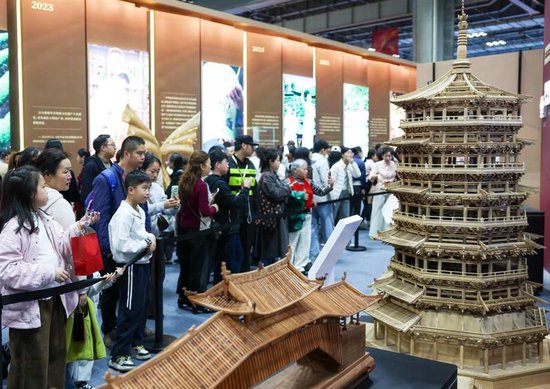
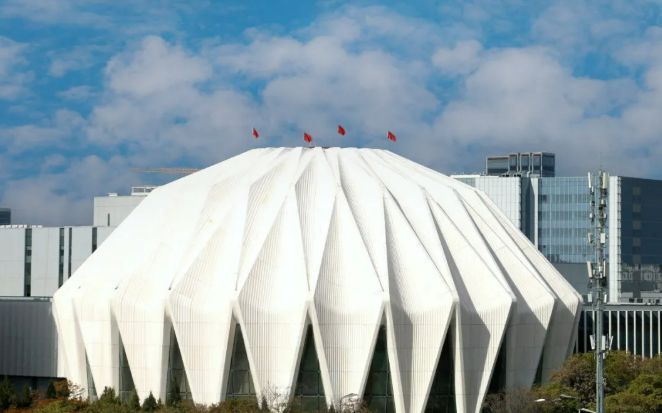
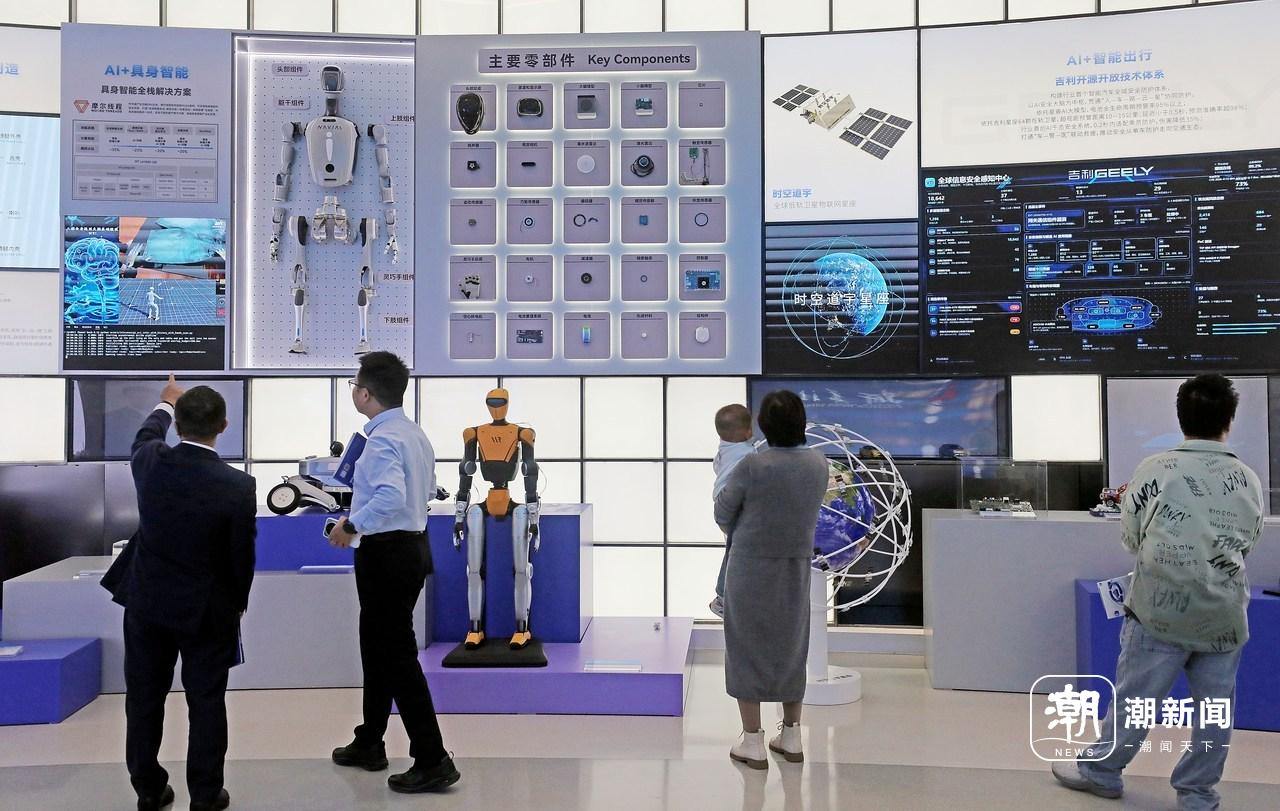 在烏鎮世界互聯網科技館內,觀眾在參觀開源主題生態體驗館。 記者 林雲龍 李震宇 攝
11月4日下午,枕水而立的烏鎮大劇院里,大講堂正熱鬧開講。窗外細雨綿綿,廳內座無虛席。
這是「烏鎮大講堂」首次面向社會公眾推出。清華大學教授、阿里雲高管、外文出版社主編先後登台,從技術、產業、人文三個視角,講同一個題目:AI開源的下一個十年。
把峰會的一角辦成一間向所有人敞開的教室,這件事本身就帶著開源的意味——把「大咖的盛會」變成「大家的盛會」,把專業圈層里的議題,交給願意坐下來聽的年青人。
讓機器人互相學習
「如果閉源是一座精心修建的私家園林,只有一部分人能進去看,那麼開源更像全人類共建的市政公園和高速公路。」清華大學電子工程系長聘教授、杭州市開源人工智能基金會理事長汪玉,用一個比喻開場。在他看來,沒有開源,就沒有今天互聯網和移動互聯網的快速發展。
然而,隨著數字空間的基礎設施已慢慢成形,他有了新的思考:數字世界那套東西,能不能直接搬給機器人用?
汪玉得出的答案是不能,原因有三。一是機器人的「腦子」還沒定型:數字世界模型已到萬億級,具身智能才幾十億,而物理世界連續、不可預知,算法尚未收斂。二是機器人的「教材」不夠:機器人要拿話筒、擰瓶蓋、搬東西,得在真實世界里動手。三是算力不集中在一起:家裡、工廠、每台機器上都有算力,是雲邊端協同,跟數字世界完全不一樣。
怎麼辦?不是等一個萬能模型從天而降,而是用開源開放的方式,給機器人重新搭一套「學校」:底層有開源本體當教具,開放傳感器、執行器、靈巧操作;中間有訓練平台把機器人管起來,把成功和失敗的經驗收上來、訓練完再發下去;上面有開放的具身模型;兩邊有開放數據集和評測,看它到底能不能完成任務;最上面才是千行百業的應用。
這套「學校」里最有趣的是訓練。
機器人出廠不一定會幹某個特定任務,怎麼讓100個機器人快速學會?靠人遙操作教,人不夠,培訓也來不及。他們做了一個實驗,進一步用96台真機互相學習,形成集體經驗——哪台成功了、哪台失敗了,經驗可以啟發其他機器人。只要擴大機器人規模,就能讓它們快速學會能力。
這就是開源開放在物理世界的版本:不只是開放代碼,而是讓機器人之間互相學習、經驗共享。
暢想未來,解決物理世界問題後,還可以把目光推到太空。如果地面上機器很強,算力也很強,而我們有很好的運載能力,那是不是可以把機器人送到月球上,幫我們建城?「因為我們還是要拓展人類的生存空間。至少要在技術層面,把這一類基礎設施的能力摸透。」汪玉說。
把你的經驗變成AI能調用的skill
今年4月,北郵附近一家叫金穀園的餃子館,在GitHub上發佈了自己的skill。
有人笑:一個煮餃子的,湊什麼熱鬧?
阿里雲智能集團副總裁、阿里雲科技研究中心主任安筱鵬卻說,嘲笑的人根本沒理解這個行為的價值。
「這個skill不是給歐洲人看的,也不是給美國人看的,是給AI看的。」他給大家分享了一個理念——AI時代一個重要的認知轉變:skill,也就是「技能」,正在成為AI時代的軟件。
skill到底解決了什麼問題?Anthropic兩位專家的說法是:面對一份複雜的報稅任務,你不需要一個智商300的數學家,你需要一個有20年經驗的稅務專家。而稅務專家的經驗,可以變成一種技能,被AI調用。
大模型學完了互聯網上所有公開的知識,但它沒學過律師怎麼思考問題,也沒學過你怎麼寫文章、怎麼起標題、怎麼搭結構。這類隱性的、屬於你個人的知識,在互聯網上學不到。
「但今天,你可以把它沉澱成skill,讓AI去調用。」他打了個比方:skill就像孫悟空拔一根毫毛,一根毫毛能變出100個、1000個孫悟空。每個人除了擁有大模型,還需要把自己的經驗、方法沉澱下來,用skill去幫更多人。
開源,正是讓這件事跑起來的底層邏輯。
他舉了兩個例子,一個是爬珠峰。開源相當於派一架直升機,把你從地面送到海拔5200米的珠峰大班營;如果有一個強大的開源體系,那是有很多架直升機把你送到大班營——但從5200米到8800米,得你自己爬。開源降低創新門檻、提高效率、加速普惠。
另一個有關盧保獎。2024年幾位與AI相關的科學家獲得盧保化學獎和物理學獎,他們都把自己的方法開源出來,讓它成為下一輪競賽的公共基線。這就是「競賽—開源—創新」的循環。
放進更長的歷史看,從文字到印刷術到AI,人類文明就是一部知識壓縮與轉化的歷史,一部壓縮效率不斷進化的歷史。在安筱鵬看來,skill只是走到了一個新的階段。它的邏輯,本質上是一次知識層面的開源。
人要去做尚未被定義的事
一句18個單詞的譯文,被ChatGPT改了7處。人機之間,誰更懂表達?
外文出版社榮譽英文主編、中國政府友誼獎獲得者大衛·費格遜第三個登台講課,他先講了一件小事。
一位同事把他改過的一句譯文拿去問ChatGPT,開啟了一場人機翻譯能力的小比賽。他一句一句比對,最後表示:7處里只有1處比他的好——「scars」比「wounds」好,因為更有畫面感。其餘6處,都不如他。
「這是我第一次真正被迫去思考:AI 在翻譯中到底扮演什麼角色。」大衛·費格遜發現,大語言模型從互聯網的海量文本里學習,而寫作、翻譯、編輯呈現出一種「鍾形曲線」現象:極少數人做得極好,絕大多數人水平平平。也就是說,AI能從「優秀」人群裡采到的樣本很少,能從「平庸」人群裡采到的樣本卻極多。「於是大語言模型得出結論:平庸就是好的,因為平庸的樣本最多。」所以ChatGPT犯的錯,恰恰是他預期一個平庸譯者會犯的錯;ChatGPT認為漂亮的表達,恰恰是他眼裡平庸的表達。
一個問題隨之浮出來:AI到底強在哪裡、弱在哪裡?人又該做什麼?他的判斷是,AI在「有對有錯」的領域極強,比如STEM學科、答案明確的法律流程;但在需要判斷、需要主觀性的地方,它吃力得多。AI的判斷來自它吃進去的樣本。開源開放不只是開放模型,也關乎數據、語境和判斷的來源。
「那麼,譯者、口譯員的未來在哪?」一位觀眾提問。
他的回答出其不意:講故事。
他說,譯者太寶貴了,不該被浪費在給AI改錯上。翻譯這個行當的工作方式,一定會變。以他60年的經驗,也因為他自己會說四門語言——語言好的人往往文字也好,這意味著他們是好的講故事的人。
當AI把「平庸」變得唾手可得,人更要去做那些尚未被定義、卻至關重要的事。他說,未來,不是「你怎樣才能更好地去配合AI工作」,而是「你怎樣才能成為一個目前還不真正存在、但至關重要的行業的一部分」。
「轉載請註明出處」
責任編輯:王晶